ページ全体をスキャン 人にも、AI にも
レイアウトは一度、出力は二つ
ページをスクロールしながらスクリーンショットをつなぎ合わせるキャプチャは、見た目は正しくても死んだファイルになります。選択できる文がなく、Ctrl+F が効かず、100% を超えると潰れます。この拡張機能はページを本来の全高で一度だけレイアウトし、Chrome に印刷させるので、切り抜くプレビューと手元に残る PDF は同じレイアウトです。
ページ全体のキャプチャ
クリック一回、または Alt+Shift+P で、目の前の一画面ではなくスクロールの末尾までページ全体を取り込みます。
文字は文字のまま
選択でき、検索でき、コピーできます。画像はベクターのままなので、拡大しても崩れません。
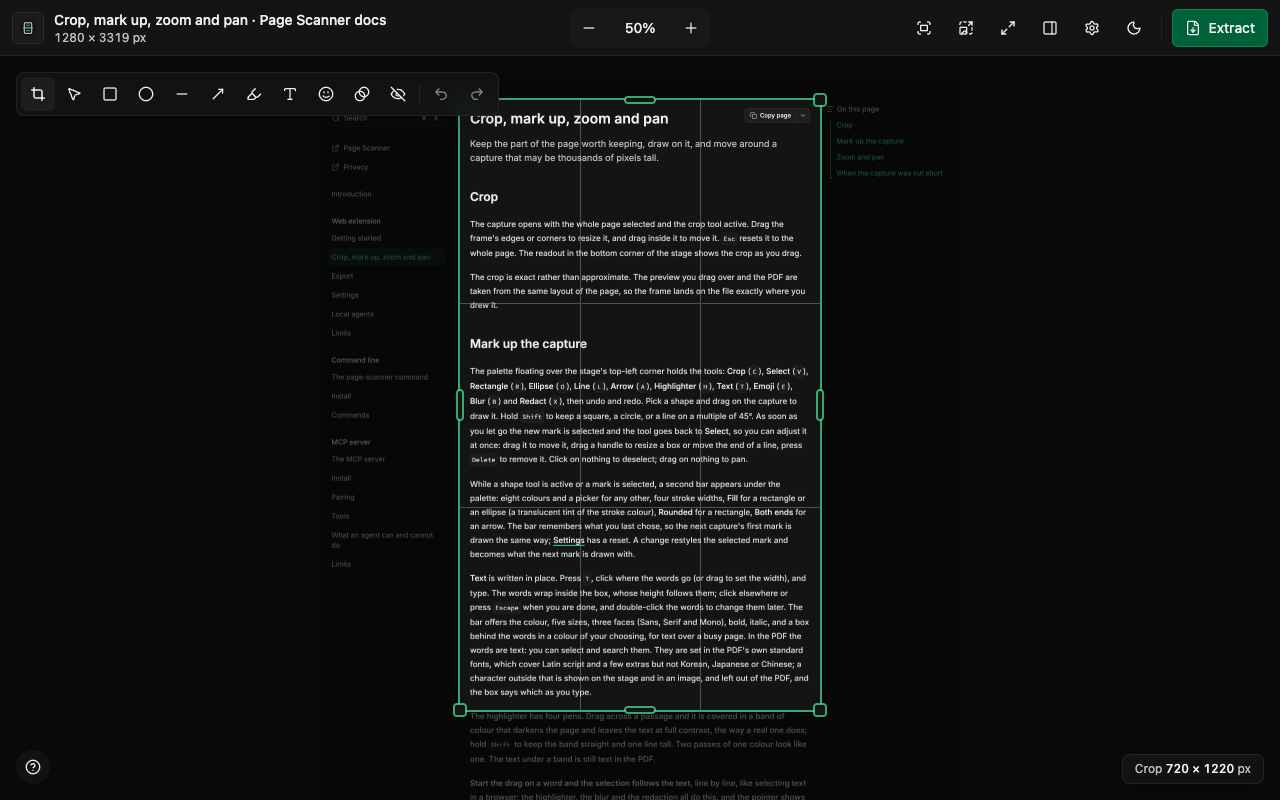
ぴったりの切り抜き
エディタで四角形をドラッグすると、ファイルはその範囲そのものになります。プレビューと PDF が一つのレイアウトから出るので、切り抜きがずれることはありません。
印刷できるページ
A4 または US Letter の幅でキャプチャすると、用紙に原寸で印刷され、16px の本文が 12pt になります。調整している間もページ数と切れ目がキャプチャの上に描かれ、それぞれの改ページは文の途中ではなく空いた行へ移ります。
キャプチャへの描き込み
四角形、矢印、蛍光ペン、テキスト、絵文字、ぼかし、黒塗りをエディタで描くと、すべての書き出しに載ります。PDF の中で図形はベクター、テキストは文字です。黒塗りの下の言葉は覆われるのではなく、ファイルから消えます。
スタンプと枠
ページのアドレスとキャプチャ時刻を載せた帯(任意)。PDF ではアドレスがリンクになります。出力の周りの余白と枠で、白いスライドに貼った白いページにも縁が付きます。
三つの形式
一度のキャプチャが PDF、可逆圧縮の PNG、ずっと小さい JPEG になります。PNG はファイルの代わりにクリップボードへ直接送れます。
覚えています
エディタは前回使った色、線の太さ、形式、レイアウトで開きます。フォームで設定するのではなく使い方から学び、設定ページでリセットできます。
何もコンピュータから出ません
拡張機能にはホスト権限も、解析ツールも、Cookie もアカウントもありません。このウェブサイトは Google Analytics で訪問を数えており、その範囲はプライバシーポリシーに書いてあります。
スクリプトからも、エージェントからも
npm の二つのパッケージが、すでにサインインしている Chrome を通じて拡張機能と同じキャプチャを行うので、ログインの先にあるページもログイン済みのページです。コンピュータとブラウザを一度ペアリングすれば、どちらも二度と尋ねません。
コマンドライン
@page-scanner/cli はスクリプトからページをキャプチャし、指定した場所に PDF を書き出します。ブラウザが通信するデーモンもここにあります。
npx @page-scanner/cli scan --url https://example.com --out ./page.pdf
Model Context Protocol
@page-scanner/mcp は pair、list_browsers、list_tabs、scan_page の四つのツールを持つ stdio サーバーです。127.0.0.1 のローカルブリッジを通じてブラウザに届き、それ以外のどこにも届きません。
claude mcp add page-scanner -- npx -y @page-scanner/mcp