扫描整个网页 给人看,也给 AI 看
一次布局,两种输出
一边滚动页面一边把截图拼起来的捕获,给你的是一个看起来没错却是死的文件:没有一句话能选中,Ctrl+F 不起作用,放大超过 100% 就糊了。这个扩展程序把页面按真实的全高只排版一次,再让 Chrome 打印,所以你裁剪的预览和你留下的 PDF 是同一个布局。
整页捕获
点击一次,或按 Alt+Shift+P,捕获的是滚动到底的整个页面,而不是眼前的一屏。
文字仍然是文字
可以选中、搜索、复制出来。图形保持矢量,放大也不糊。
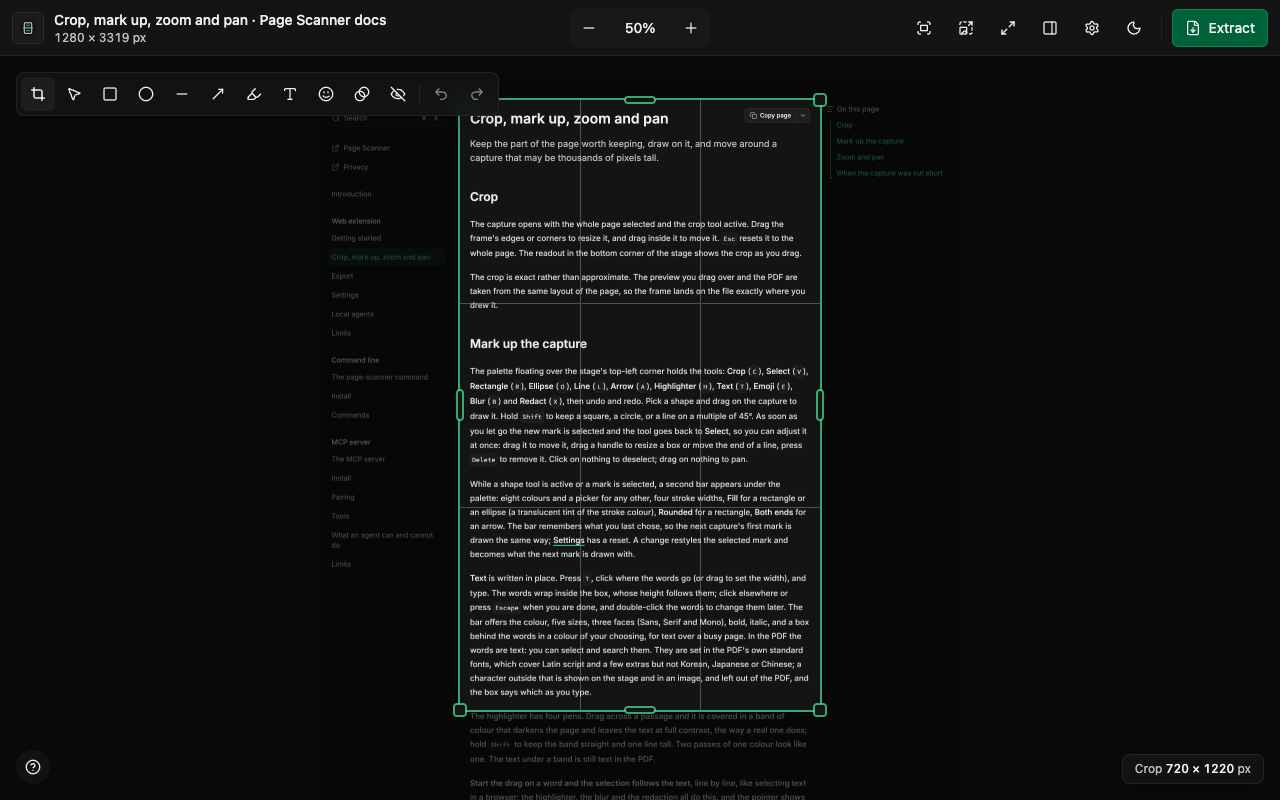
精确的裁剪
在编辑器里拖出一个矩形,文件就落在那里。预览和 PDF 出自同一次布局,裁剪不会偏移。
能打印的页面
按 A4 或 US Letter 宽度捕获,纸张以原尺寸打印,16px 的正文变成 12pt。调整的时候页数和分页线就画在捕获上,每条分页线都移到空行,而不是切在句子中间。
捕获上的标记
矩形、箭头、荧光笔、文字、表情符号、模糊和涂黑,在编辑器里画好,带进每一种导出。在 PDF 里图形是矢量,文字是文字;涂黑下面的字是从文件里删掉的,不是盖住的。
印记和边框
一条可选的横条,载有页面地址和捕获时间,地址在 PDF 里是链接。输出四周的留白和边框,让贴在白色幻灯片上的白色页面也有边缘。
三种格式
一次捕获可以成为 PDF、无损的 PNG,或小得多的 JPEG。PNG 可以直接进剪贴板,而不是存成文件。
记得你的选择
编辑器以你上次使用的颜色、线宽、格式和布局打开,从使用中学习而不是在表单里设置,设置页面上可以重置。
什么都不离开这台电脑
扩展程序没有主机权限、没有分析工具、没有 Cookie、没有账户。这个网站用 Google Analytics 统计访问,隐私政策说明了它涵盖什么。
从脚本,也从 AI 代理
npm 上的两个包通过你已经登录的 Chrome 执行和扩展程序相同的捕获,所以登录后才能看到的页面就是你已登录的页面。把电脑和浏览器配对一次,两边都不会再问。
命令行
@page-scanner/cli 从脚本捕获页面,把 PDF 写到你指定的位置。浏览器所通信的守护进程也在这里。
npx @page-scanner/cli scan --url https://example.com --out ./page.pdf
Model Context Protocol
@page-scanner/mcp 是一个 stdio 服务器,有 pair、list_browsers、list_tabs 和 scan_page 四个工具。它只通过 127.0.0.1 上的本地桥接到达浏览器,不到任何别处。
claude mcp add page-scanner -- npx -y @page-scanner/mcp